Przegląd generatorów wideo AI: Seedance, Kling, Veo, Runway, modele lokalne, awatary i upscaling - dobór modelu do ujęcia, koszty i porady z praktyki.
Krystian Wydro - AI Creative Director, OtterMind
◆◆ 12 min czytania
Generator wideo AI dobierasz do zadania: długiego ujęcia z dźwiękiem, animacji obrazu, dialogu, awatara albo edycji gotowego materiału. W pracy sięgam po Seedance 2.5 przy dłuższych scenach, Kling 3.0 przy spokojniejszych ujęciach i Veo 3.1 przy dialogach po polsku. Poniżej znajdziesz podział narzędzi na modele zamknięte, lokalne, rozwiązania do animowania postaci oraz edycji i poprawy jakości wideo.
Nie układamy rankingu. Zestaw modeli zmienia się zbyt szybko. Porównujemy rodzaj kontroli i użyteczność wyniku.
Jeden generator może lepiej prowadzić ruch kamery, drugi lepiej zachować twarz. Model wybieramy dla ujęcia, a nie dla całego projektu z przyzwyczajenia.
Linki do Magnific i ComfyUI w tym artykule są partnerskie. Gdy skorzystasz przez nie z płatnej oferty, otrzymuję wynagrodzenie. Cena dla Ciebie pozostaje taka sama, a prowizja pomaga mi rozwijać bazę wiedzy.
Płatne generatory wideo AI: który do jakiego zadania?
W tej grupie znajdują się modele do generowania i edycji wideo. Różnią się możliwościami pracy z ruchem, dźwiękiem oraz materiałami referencyjnymi. Warto zacząć od ustalenia, co ma wydarzyć się w ujęciu i jakiej kontroli potrzebujesz.
Z praktyki: zanim wybierzesz model. Ta sama platforma może udostępniać kilka modeli. Ten sam model może pojawić się w kilku narzędziach, ale z innymi ustawieniami, limitami i ceną. Dlatego przed projektem sprawdzam nazwę modelu, długość klipu, proporcje, rozdzielczość, obsługiwane referencje, możliwość generowania dźwięku oraz warunki wykorzystania komercyjnego.
Seedance 2.5 - dłuższe ujęcie z dźwiękiem
Seedance 2.5 prowadzi pod względem jakości generowanego materiału, ale należy też do najdroższych rozwiązań. Pozwala przygotować pojedynczy materiał trwający do 30 sekund. Możesz przekazać mu referencje graficzne, dźwiękowe i wideo.
Sięgam po niego, gdy potrzebuję dłuższego ujęcia z obrazem i dźwiękiem. Jeden przebieg pomaga zachować ciągłość, ale wymaga dokładniejszego opisania kolejnych wydarzeń. Jeżeli potrzebujesz precyzyjnej kontroli nad ruchem, na przykład tempa zmiany wyrazu twarzy albo synchronizacji gestu z tekstem, Seedance pozwala na bardziej szczegółowe sterowanie dynamiką sceny.
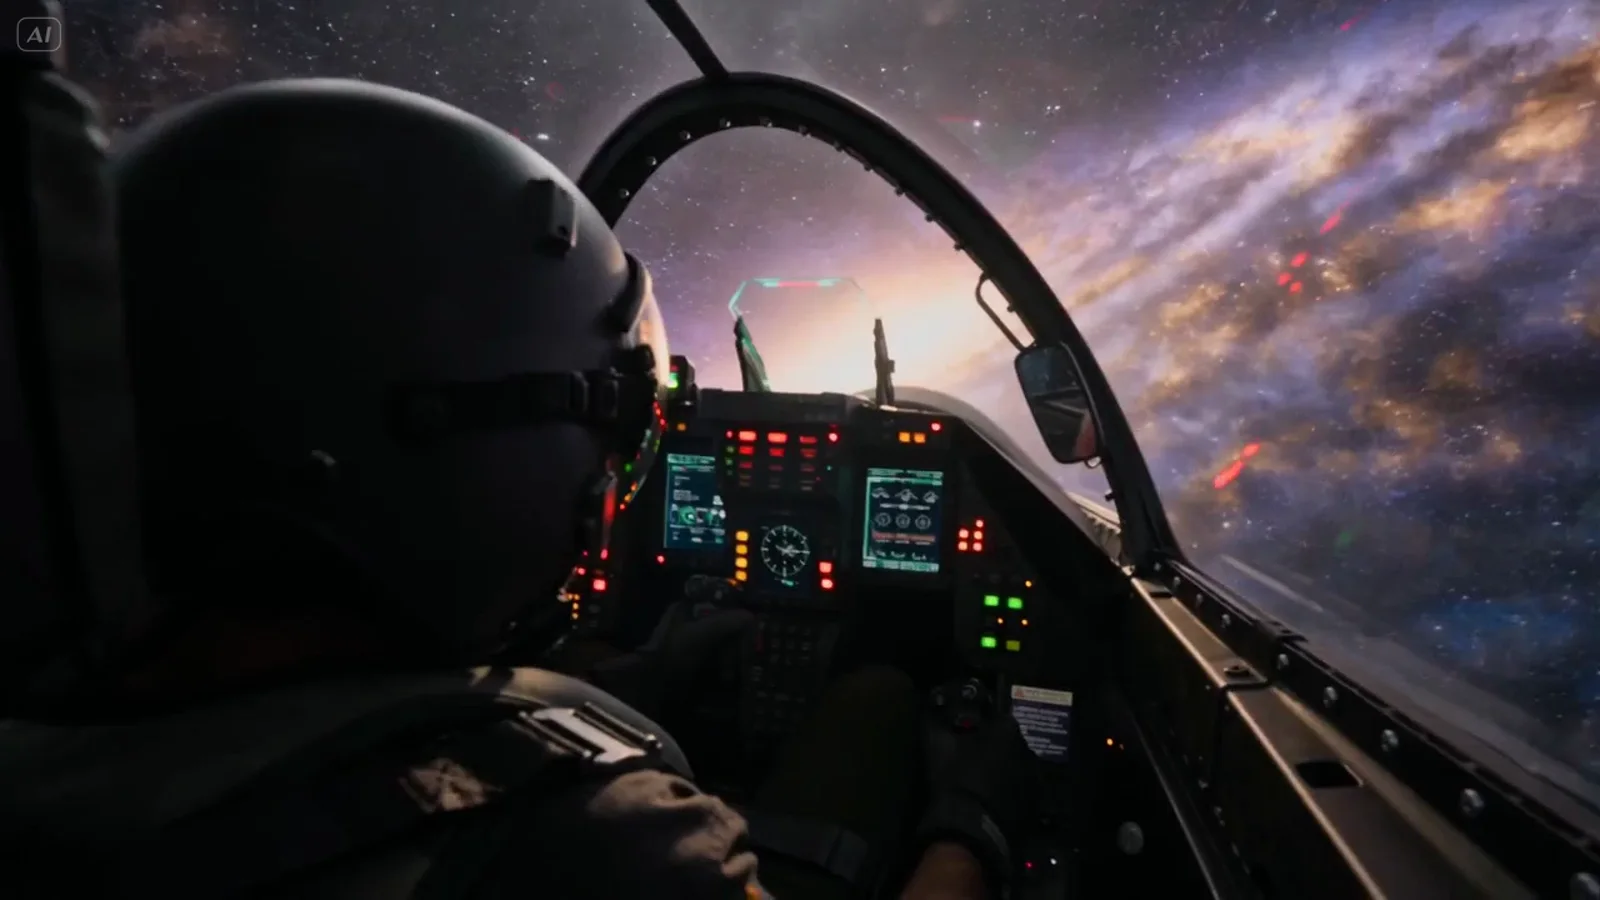
Seedance 2.5 - pościg w jednym 30-sekundowym ujęciu, z dźwiękiem
Kling 3.0 - spokojne ujęcia i animacja między klatkami
Kling 3.0 jest alternatywą dla Seedance, szczególnie przy spokojniejszych ujęciach. Dobrze radzi sobie z animacją pomiędzy klatką początkową i końcową. Sprawdzam go również wtedy, gdy w spokojnej scenie zależy mi na detalach w tle.
Veo 3.1 wybieram do ujęć opartych na dialogu po polsku. Jego możliwości wizualne oceniam jako bardziej ograniczone niż w Seedance czy Kling, natomiast mocną stroną pozostaje dźwięk. Model pozwala wygenerować polski głos, który brzmi całkiem naturalnie.
Gemini Omni Flash
Gemini Omni Flash to model wideo Google. Jego opis wskazuje na lepsze rozumienie fizyki, ruchu i interakcji między obiektami. Ma również służyć do edycji wideo.
Luma Ray - generowanie w HDR
Luma Ray to rodzina modeli, która odegrała dużą rolę w animowaniu obrazu pomiędzy klatkami. Wyróżnia się możliwością pracy z materiałem o szerszym zakresie jasności, czyli generowaniem w HDR. Luma to jedyny model generujący w trybie HDR. Jednocześnie oceniam, że jakość generowanego materiału pozostaje w tyle za konkurencją.
Runway Gen-4.5 - złożona akcja i ruch kamery
Runway Gen-4.5 wybieram do bardziej złożonej rozpiski akcji i ruchu kamery. Runway należał do pionierów generowania wideo. Gen-4.5 obsługuje text-to-video oraz image-to-video. Aleph służy do edycji istniejącego filmu, a Act-Two przenosi ruch i mimikę z nagrania referencyjnego - oba opisuję w dalszej części artykułu.
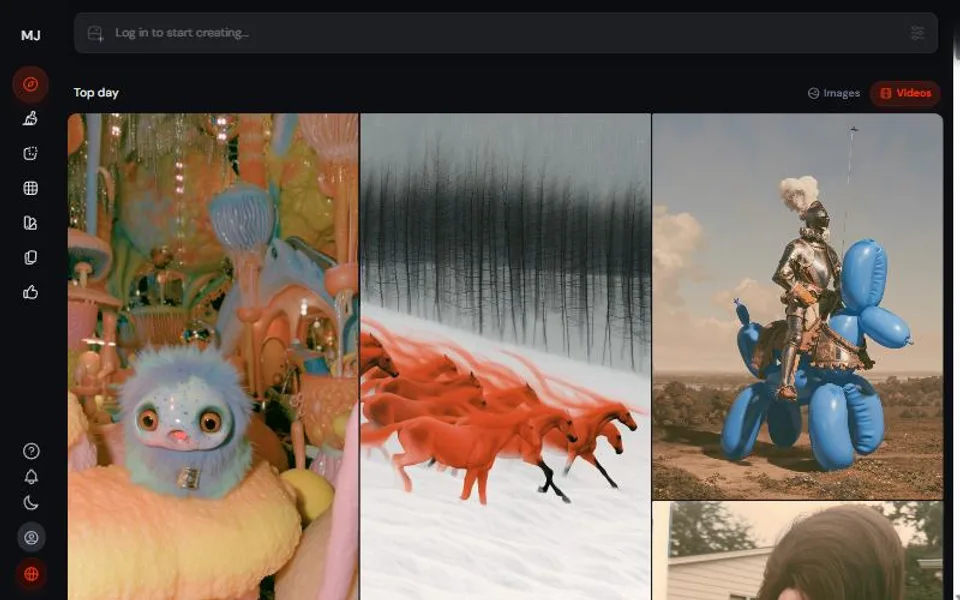
Midjourney Video
Midjourney Video pozwala animować wcześniej wygenerowane obrazy. Testuję go wtedy, gdy kierunek wizualny projektu powstał w Midjourney.
Happy Horse, Wan 3.0 i FLUX 3
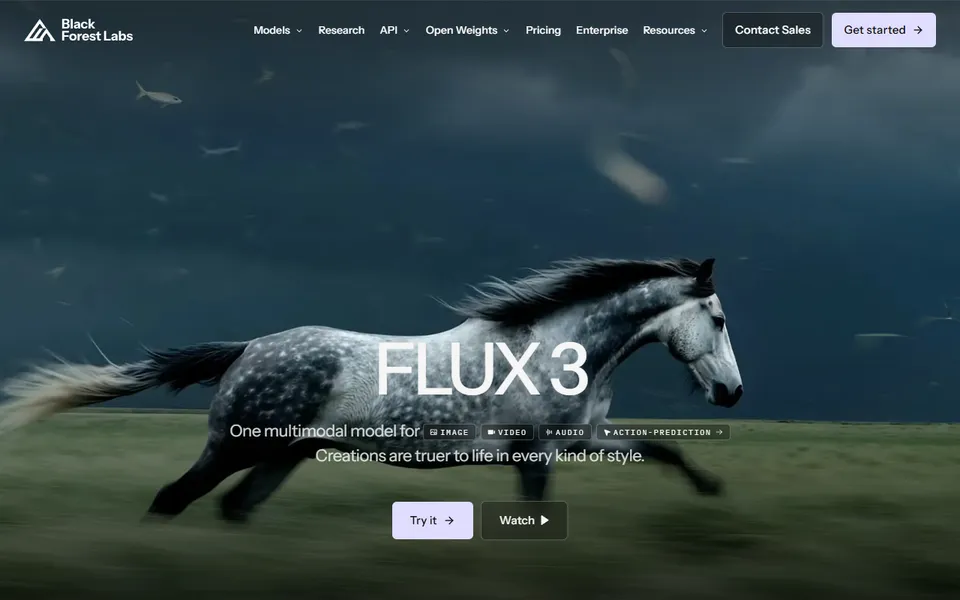
Happy Horse jest jednym z zamkniętych, płatnych modeli rozwijanych w Chinach. Wan jest szczególnie ciekawy w kontekście edycji wideo. Wcześniejsze wersje były dostępne jako open-weight. Wan 3.0 jest zamknięty, dlatego trafił do grupy modeli zamkniętych. FLUX 3 jest pierwszym modelem wideo w rodzinie kojarzonej wcześniej z generowaniem grafiki. Dobrze odwzorowuje ruchy kamery i ma ciekawą estetykę. Pozwala generować ujęcia trwające do 20 sekund.
FLUX 3 - 20-sekundowe ujęcie z prowadzeniem kamery
Modele lokalne możesz włączyć do własnego procesu pracy. W ComfyUI połączysz generowanie z referencjami, maskami, kontrolą obrazu i kolejnymi etapami obróbki. Warto przy tym uwzględnić wymagania sprzętowe: wyższa rozdzielczość, dłuższy materiał i dodatkowe węzły zwiększają zapotrzebowanie na pamięć.
Lokalny workflow daje dostęp do ustawień modelu, węzłów, masek, map kontroli oraz automatyzacji. Materiały mogą zostać w naszej infrastrukturze, co ma znaczenie przy niewprowadzonym jeszcze produkcie albo potrzebie zachowania bezpieczeństwa wizerunku. W zamian potrzebujemy miejsca na dysku, odpowiedniej karty graficznej i czasu na konfigurację.
Czy to się opłaca? Praca lokalna jest za darmo, chociaż nadal ponosimy koszty karty graficznej, pozostałych podzespołów i energii, a te rzeczy ostatnio poszły cenowo w górę. Największy sens ma wtedy, gdy generujemy regularnie i wykorzystujemy tę samą konfigurację w wielu projektach. Jest też drugi argument: często po wypuszczeniu modelu w chmurze dostarczane są większe zasoby, które z czasem są redukowane i osłabiają jakość generowanego materiału.
LoRA w wideo. Swego czasu LoRy były bardzo popularne przy obrazach. Aktualnie modele do grafiki z obsługą referencji zmniejszyły ich popularność, ale w przypadku wideo LoRa wciąż ma bardzo szerokie zastosowanie.
MiniMax H3
MiniMax H3 to dziś lider wśród modeli lokalnych. Jakość generowanego materiału oceniam jako porównywalną z modelami płatnymi. Jest jednym z narzędzi, które wybieram do pracy w ComfyUI.
Licencja H3:standardowa licencja MiniMax H3 obejmuje świat z wyłączeniem Unii Europejskiej, Wielkiej Brytanii, Korei Południowej i USA. Do pracy z H3 w Polsce potrzebujesz osobnej licencji, o którą prosisz bezpośrednio MiniMax.
LTX-2.5
LTX-2.5 to kolejny model do lokalnej pracy w ComfyUI. Moje doświadczenia z rodziną LTX pokazują jednak, jak dużo zależy od rozdzielczości i sprzętu.
Po aktualizacji sterowników Nvidii praca z LTX stała się sprawniejsza, ale karta z 32 GB VRAM nie wystarczała mi do wygodnego generowania w 4K. To obserwacja z mojego środowiska pracy, a nie uniwersalny próg wymagań sprzętowych.
Do lokalnej pracy nadają się też Wan 2.2, HunyuanVideo, Mochi 1 i CogVideoX.
W tej grupie wybór zależy od tego, czy chcesz przygotować cyfrowego prezentera, ożywić zdjęcie, czy przenieść grę aktora na inną postać.
Awatar jest osobną kategorią. W typowym generatorze opisujemy człowieka i akcję. W narzędziu awatarowym podajemy tekst albo głos, a system prowadzi twarz, usta i gesty postaci.
HeyGen i Synthesia - cyfrowy prezenter
W HeyGen przygotowujesz cyfrowego prezentera, który mówi zadany tekst. To jeden z moich wyborów do klasycznego awatara. Synthesia również służy do przygotowania cyfrowego prezentera mówiącego zadany tekst. Obok HeyGen jest drugim narzędziem, po które sięgam przy takim zadaniu. Oba sprawdzają się w prezentacjach, szkoleniach i komunikacji firmowej.
OmniHuman - zdjęcie i głos
OmniHuman, udostępniany przez BytePlus, pozwala połączyć zdjęcie postaci z nagraniem głosu. Na tej podstawie generuje ruch postaci.
Runway Act-Two - gra aktora na innej postaci
Runway Act-Two przenosi mimikę, ruch głowy i gesty z nagrania aktora na obraz innej postaci. Wybieram go do przeniesienia gry aktorskiej. Łączy pracę z postacią z edycją materiału wideo. Możesz też nagrać na przykład siebie jako referencję do ruchu wygenerowanej postaci.
Z praktyki: zanim użyjesz awatara. Przy awatarach sprawdzam zgodę osoby, zasady przechowywania nagrań, licencję komercyjną, obsługiwane języki i jakość synchronizacji ust. Taki system dobrze rozwiązuje scenę mówioną. Do szerokiego ujęcia, dynamicznej akcji lub packshotu potrzebujemy innego modelu.
Ta grupa obejmuje poprawę jakości i rozdzielczości oraz modyfikowanie gotowych ujęć. Przydaje się na etapie dalszej obróbki materiału.
Topaz Video Upscaler
Topaz specjalizuje się w poprawianiu materiału wideo i zwiększaniu jego rozdzielczości. Sięgam po niego, gdy przygotowuję plik do postprodukcji. Topaz Video obsługuje też eksport 10-bitowy w wybranych kodekach, co pozwala zachować większą głębię koloru do dalszej edycji.
Runway Aleph 2.0 i Luma - zmiana ujęcia tekstem
Runway Aleph pozwala modyfikować gotowe ujęcie za pomocą tekstu. Jest jednym z rozwiązań do edycji wideo, które wyróżniam w ofercie Runway. Luma udostępnia również modyfikatory wideo. Podobnie jak w przypadku Runway Aleph, możesz pracować na gotowym ujęciu i opisywać zmiany tekstem.
Delikatna modyfikacja lepiej trzyma geometrię i ruch. Większa daje modelowi swobodę, ale częściej przebudowuje twarz, dłonie i tło.
Beeble Switch X - światło i HDR
Beeble przydaje się przy zmianie światła i wyglądu sceny. Pozwala też przekonwertować materiał do HDR.
Z praktyki: sprawdzaj klatka po klatce. Wynik oglądam klatka po klatce. Sprawdzam twarz, palce, krawędzie ubrania, kontakt dłoni z produktem, logo oraz elementy przechodzące przed postacią. Błąd pojawiający się przez dwie klatki może być prawie niewidoczny podczas szybkiego podglądu, ale stanie się wyraźny po zwolnieniu lub eksporcie.
Z praktyki: logo i tekst w postprodukcji. Takie elementy zawsze wolę dodać w samej postprodukcji, bo w wideo modele mogą bardzo przerabiać logotypy i tekst. W grafice wyglądają one dużo lepiej, więc tam można je spokojnie generować w modelach.
Koszt zależy od długości materiału, rozdzielczości i dostawcy. Poniżej znajdziesz orientacyjne kwoty dla platformy fal.
Ceny zmieniają się co miesiąc - przed generowaniem sprawdź aktualną stawkę.
Model
Długość i rozdzielczość
Orientacyjny koszt
Seedance 2.5
10 sekund, 720p
niecałe 5 USD
FLUX 3
10 sekund, 720p
około 1,70 USD
Seedance 2.5
30 sekund, Full HD
około 35 USD
Na jednym koncie fal możesz porównać koszty, czas generacji i dostępne parametry różnych modeli. Przed uruchomieniem zadania warto sprawdzić stawkę dla wybranego wariantu. Informacje o rozliczeniach znajdziesz na stronie Seedance 2.5 i w przewodniku fal po FLUX 3.
Z praktyki: najpierw tanio, potem jakość. Pierwsze wersje generuję szybciej i taniej. Składam je w montażu z roboczym dźwiękiem. Dopiero po ocenie rytmu wybieram ujęcia do ponownej generacji.
06 - Tryby generowania
Tekst, obraz czy referencja wideo?
W trybie text-to-video zaczynasz bez obrazu startowego. Podajesz prompt, a model buduje postać, lokację, kompozycję, ruch i światło. To rozwiązanie do szukania pomysłu, testowania atmosfery, przygotowania szerokiego ujęcia lub sprawdzania pracy kamery.
Gdy chcesz wiernie zachować konkretną twarz, produkt albo kompozycję ze storyboardu, sam tekst daje za mało kontroli. Wtedy potrzebujesz image-to-video lub referencji. Po wgraniu obrazu nie muszę dokładnie opisywać wszystkiego, co się na nim znajduje. Wystarczy, że opiszę na przykład ruch kamery, jaki ma się zadziać.
Referencja wideo
Trzecia droga to referencja wideo: nagranie prowadzi ruch, a model zmienia wygląd. Kling rozwija kontrolę ruchu na podstawie referencji, a Seedance 2.5 przyjmuje referencje graficzne, dźwiękowe i wideo. Runway Act-Two pozwala podmienić elementy wizualne w gotowym wideo przy zachowaniu oryginalnego ruchu. Możesz też nagrać na przykład siebie jako referencję do ruchu wygenerowanej postaci.
W takiej pracy nagranie prowadzi mimikę, ruch głowy oraz gesty. Oddzielnie kontroluję głos, obraz postaci oraz nagranie ruchu. Gotowy klip mogę też przekształcić w narzędziach takich jak Aleph - delikatna modyfikacja lepiej trzyma geometrię i ruch.
Seedance 2.5 z referencją wideo - ruch rycerza z animacji w EVRN
Klatka początkowa i końcowa
Obie klatki muszą przedstawiać tę samą dłoń, ten sam produkt, kostium, lokację i kierunek światła. Jeżeli punkt A i B różnią się całym światem, model nie wykona ruchu. Wykona morfing. Prompt opisuje drogę, nie zakończenie: ostatnia klatka pokazuje już pozycję docelową, a tekst wyjaśnia, jak bohaterka ma się tam znaleźć.
Gdy przejście wychodzi nienaturalnie, zmniejszam różnicę pomiędzy obrazami albo wydłużam czas. Mogę też przygotować klatkę pośrednią i podzielić ujęcie na dwa odcinki. Modele mają ograniczony czas jednej generacji, ale ten czas możesz wydłużyć: ostatnią klatkę ujęcia bierzesz jako początkową kolejnego.
Referencje postaci
Każda kolejna referencja dostarcza informacji, ale może też konkurować z wcześniejszymi. Dlatego nie wrzucam od razu całego folderu. Postać pokazuję z przodu, z profilu i w ujęciu trzy czwarte.
Jak pisać prompt do wideo?
Prompt do grafiki opisuje głównie wygląd pojedynczej chwili. Prompt do wideo musi opisać zmianę w czasie. Zaczynam od prostego działania. Jeśli bohaterka jednocześnie biegnie, obraca się, podnosi produkt, mówi do kamery, a operator wykonuje orbit i zoom, model musi rozwiązać zbyt wiele rzeczy naraz. Dzielę taką scenę na osobne ujęcia.
07 - Dobór modelu
Jak dobrać model wideo do ujęcia i oszczędzić kredyty?
Zasada wyboru brzmi: użyj najprostszego trybu, który zabezpiecza największe ryzyko ujęcia. W praktyce wystarczą 2-3 modele do wideo, na przykład Veo, Kling i Seedance. Reszta to sytuacyjne dodatki.
Z praktyki: jeden prompt, kilka modeli. W Magnificu możemy wygodnie porównać kilka modeli w jednym miejscu. Wprowadzam ten sam prompt, zachowuję proporcje i długość, a następnie zestawiam wyniki. Sprawdzam zgodność z opisem, fizykę ruchu, stabilność twarzy i dłoni, zachowanie produktu, pracę kamery oraz to, ile sekund materiału rzeczywiście nadaje się do montażu.
Zasada 30-45 minut. Jeśli coś zajmuje Ci dłużej niż 30-45 minut i wynik dalej jest słaby, przeskocz na inny model. Tutaj najlepiej sprawdzają się aplikacje, które agregują różne modele w jednym miejscu.
Montaż ratuje ujęcie. Bywa tik w rytmie, a przy skokach zdarza się, że postać zaczyna latać. Czasem jedynym wyjściem jest magia montażu i ucięcie animacji w odpowiednim momencie. Gdy model wygenerował dźwięk, którego nie potrzebujesz, po prostu go wycisz i dodaj własną ścieżkę.
Z praktyki: wstępny montaż z agentem. Agent, taki jak Claude Code, Codex czy Antigravity, może poprowadzić cały montaż roboczy. Wyodrębnia dźwięk, robi transkrypcję z czasami słów i układa listę cięć. FFmpeg tnie i skleja fragmenty w roboczy plik MP4, a napisy są przeliczane na oś czasu zmontowanej wersji. Wskazujesz cytat, kolejność ujęć albo temat, a agent dopasowuje fragmenty z nagrania. Rytm i sens łączeń oceniasz już sam, na gotowym podglądzie.
Nie ma jednego najlepszego. Seedance 2.5 sprawdza się przy dłuższych scenach z dźwiękiem, Kling 3.0 przy spokojniejszych ujęciach, a Veo 3.1 przy dialogach po polsku. Model wybierasz dla ujęcia, a nie dla całego projektu.
Który generator wideo AI mówi po polsku?
Do ujęć z dialogiem po polsku wybieram Veo 3.1. Model generuje polski głos, który brzmi całkiem naturalnie.
Ile kosztuje wygenerowanie wideo AI?
Orientacyjnie na platformie fal: Seedance 2.5 to niecałe 5 USD za 10 sekund w 720p i około 35 USD za 30 sekund w Full HD, a FLUX 3 około 1,70 USD za 10 sekund w 720p. Przed uruchomieniem zadania sprawdź aktualną stawkę.
Czy wideo AI można generować lokalnie?
Tak. Modele lokalne, takie jak MiniMax H3, LTX-2.5 czy Wan 2.2, uruchamiasz w ComfyUI. MiniMax H3 w Unii Europejskiej wymaga osobnej licencji od producenta. Nie płacisz za generację, ale potrzebujesz odpowiedniej karty graficznej, miejsca na dysku i czasu na konfigurację.
Jak zrobić awatara AI?
Do cyfrowego prezentera, który mówi zadany tekst, służą HeyGen i Synthesia. Przed użyciem sprawdź zgodę osoby, licencję komercyjną, obsługiwane języki i jakość synchronizacji ust.
Text-to-video czy image-to-video?
Text-to-video służy do szukania pomysłu, atmosfery i szerokich ujęć. Gdy musisz zachować konkretną twarz, produkt albo kompozycję ze storyboardu, wybierz image-to-video lub referencje.
Czy można użyć własnego nagrania jako referencji ruchu?
Tak. Kling rozwija kontrolę ruchu na podstawie referencji, Seedance 2.5 przyjmuje referencje wideo, a Runway Act-Two przenosi mimikę, ruch głowy i gesty z nagrania aktora na inną postać.
Jak wydłużyć wideo AI?
Modele mają ograniczony czas jednej generacji. Ostatnią klatkę ujęcia możesz wykorzystać jako klatkę początkową kolejnego i złożyć dłuższą scenę w montażu.
Ile modeli do wideo potrzebujesz?
W praktyce wystarczą 2-3 modele do wideo, na przykład Veo, Kling i Seedance. Reszta to sytuacyjne dodatki.
Używam niezbędnych plików cookies. Za Twoją zgodą włączę też cookies analityczne i marketingowe. Polityka prywatności